ZFS sous Linux : maîtriser les pools et les instantanés pour mieux protéger ses données
ZFS sous Linux : maîtriser les pools et les instantanés pour mieux protéger ses données
ZFS sous Linux est un système de fichiers et gestionnaire de volumes qui regroupe les disques dans des pools, vérifie les données par somme de contrôle et crée des instantanés rapides. ZFS peut améliorer la résilience d’un serveur ou d’un NAS, mais un pool redondant ne remplace ni une sauvegarde hors site ni une procédure de restauration testée.
Le point de départ consiste à choisir la structure du pool avant toute commande de création : miroir, RAIDZ ou stockage sans redondance. Ce guide explique les concepts d’OpenZFS sous Linux, les commandes à adapter à votre environnement, les contrôles d’intégrité et les limites à connaître avant de confier des données importantes à ZFS.
En bref
🧩 Un pool ZFS est l’ensemble de stockage physique ; les datasets organisent ensuite les données avec leurs propres propriétés.
📸 Un instantané ZFS conserve l’état d’un dataset à un instant donné, mais reste dépendant du pool tant qu’il n’est pas répliqué ailleurs.
🔍 Les sommes de contrôle et la scrutation détectent les incohérences ; une redondance adaptée peut permettre une réparation automatique.
⚠️ La commande zpool create peut effacer les disques indiqués : vérifiez toujours les identifiants persistants avant validation.
Comprendre ce qu’est ZFS sous Linux
ZFS est un système de fichiers et un gestionnaire de volumes qui administre le stockage comme un ensemble cohérent, depuis les disques physiques jusqu’aux systèmes de fichiers. OpenZFS sous Linux apporte notamment les pools, les datasets, la compression, les instantanés, la réplication et la vérification d’intégrité des blocs. Son intérêt concret est de réduire les angles morts entre la couche RAID logicielle, les volumes et le système de fichiers.
Le vocabulaire compte, car les erreurs de conception commencent souvent par une confusion entre un disque et un pool. Un vdev est un groupe de disques qui fournit de la capacité et, selon sa structure, de la redondance. Un pool, nommé zpool, agrège un ou plusieurs vdev. Les datasets sont enfin les espaces logiques créés dans ce pool, avec des propriétés indépendantes.
| Élément ZFS | Rôle | Exemple | Point de vigilance |
|---|---|---|---|
| Disque | Support physique ou virtuel | /dev/disk/by-id/... |
Préférer un identifiant stable à /dev/sdX |
| Vdev | Unité de capacité et de redondance | Miroir de deux disques | La perte de trop de disques dans un vdev compromet le pool |
| Pool ZFS | Réunit les vdev | tank |
Sa topologie doit être pensée avant création |
| Dataset | Système de fichiers logique | tank/documents |
Les quotas et la compression se règlent souvent ici |
| Instantané | État figé d’un dataset | tank/documents@avant-maj |
Il ne protège pas contre la perte du pool |
Les sommes de contrôle et l’autoréparation
ZFS calcule une somme de contrôle pour les blocs qu’il écrit et la vérifie lors de leur lecture. Une divergence entre la donnée lue et sa somme de contrôle attendue signale une corruption détectable. Lorsqu’un pool dispose d’une copie saine dans un miroir ou une configuration RAIDZ, ZFS peut réparer le bloc défectueux à partir de cette copie.
Une somme de contrôle ZFS ne prévient pas chaque incident matériel. Elle ne remplace pas la surveillance des disques, l’alimentation secourue, les alertes ni les sauvegardes. La documentation officielle d’OpenZFS décrit les propriétés et commandes à utiliser selon la version installée.
Un pool redondant améliore la disponibilité des données ; une sauvegarde indépendante reste nécessaire pour survivre à la perte du site, au vol ou à une erreur administrative.
Préparer le système Linux avant de créer un pool
OpenZFS est disponible sur plusieurs distributions Linux, mais le paquet, le module noyau et la procédure d’installation varient. Les versions compatibles dépendent aussi du noyau utilisé. Le projet OpenZFS publie une matrice de compatibilité et des notes de version dans son dépôt officiel : vérifiez-les avant une mise à niveau du noyau ou de la distribution.
Sur Debian ou Ubuntu, le paquet utilitaire porte couramment le nom zfsutils-linux. La présence du paquet ne garantit toutefois pas que le dépôt requis soit activé ni que le module soit déjà chargé. Une installation doit donc être validée par les commandes zfs version et zpool version, plutôt que supposée fonctionnelle.
- Identifiez les disques avec
lsblk -o NAME,SIZE,MODEL,SERIALavant toute création. - Utilisez de préférence les chemins présents dans
/dev/disk/by-id/. - Vérifiez l’état SMART des disques avec l’outil adapté à votre distribution.
- Réservez une sauvegarde existante pour les données déjà présentes sur les supports ciblés.
- Documentez la topologie prévue : nombre de disques, type de vdev, capacité utile et tolérance de panne.
Comment concevoir et créer un pool ZFS sans effacer le mauvais disque ?
Pour créer un pool ZFS sans erreur, il faut d’abord identifier les disques par leur identifiant persistant, choisir une topologie compatible avec le niveau de redondance attendu, puis relire la commande avant son exécution. La création d’un pool initialise les supports indiqués : une confusion entre deux disques peut détruire des données existantes.
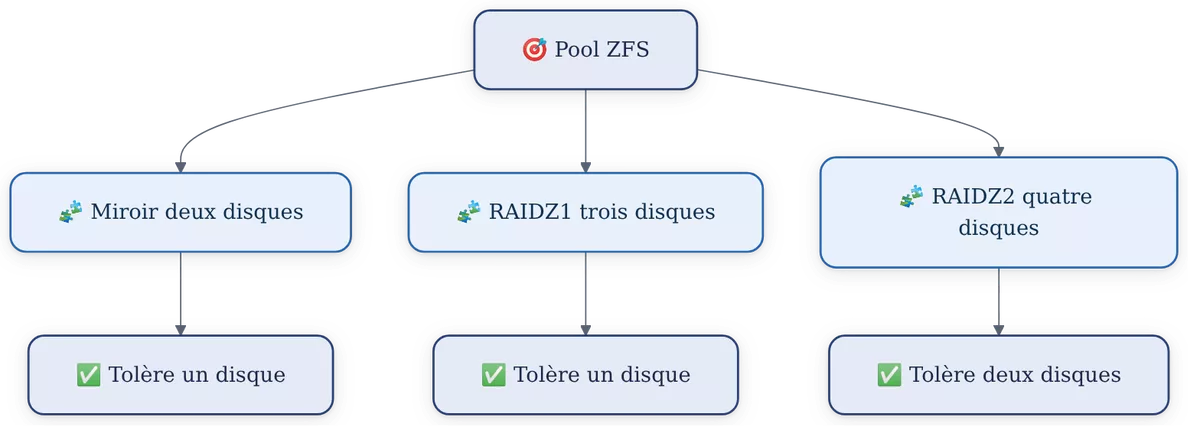
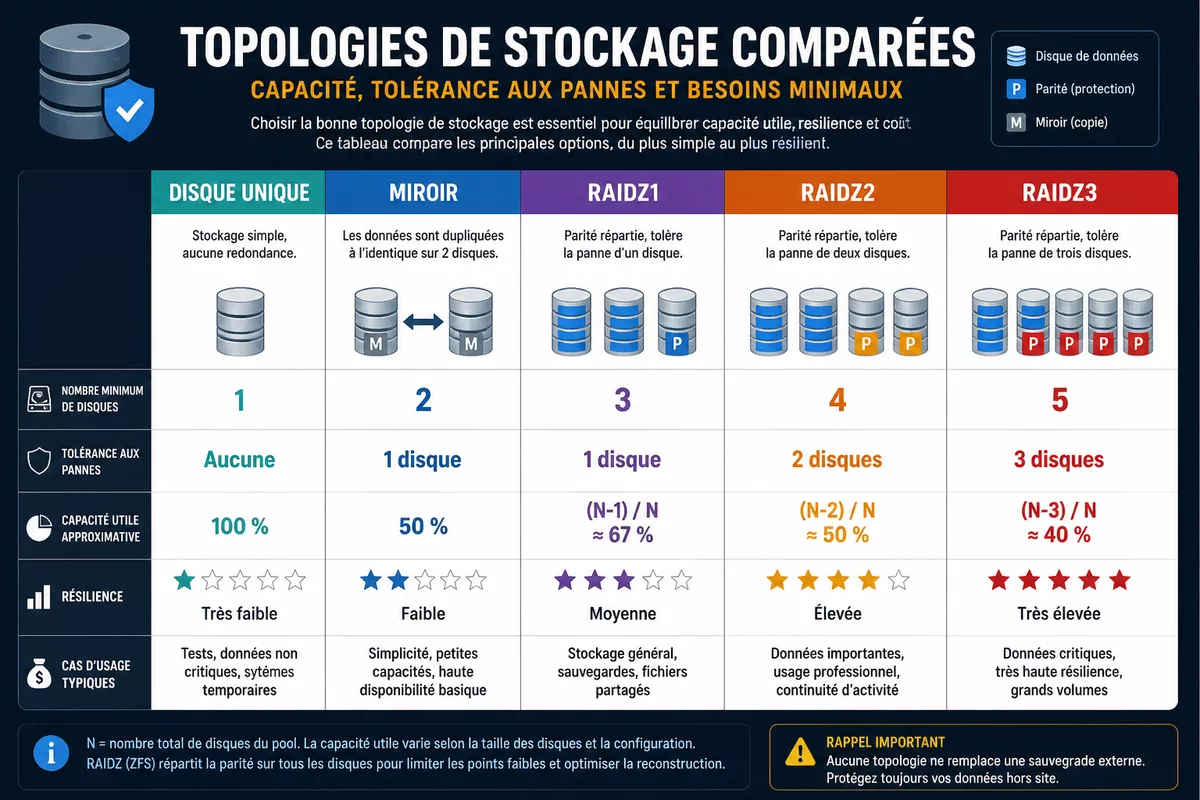
Un miroir ZFS duplique les données sur deux disques ou plus et privilégie généralement les lectures parallèles. RAIDZ répartit les données et la parité entre plusieurs disques. La documentation OpenZFS recommande au minimum trois disques pour RAIDZ1, quatre pour RAIDZ2 et cinq pour RAIDZ3, afin de disposer d’une capacité de données réelle en plus des informations de parité.
Miroir ZFS, RAIDZ et disque unique : quel compromis ?
Le choix ne dépend pas seulement du nombre de disques disponibles. Un miroir est souvent plus simple à expliquer et à remplacer, car chaque disque contient une copie complète des données. RAIDZ améliore l’efficacité de capacité avec plusieurs disques, mais sa géométrie doit être décidée avant le déploiement. Ajouter un disque à un vdev existant n’est pas une opération universelle : les possibilités dépendent de la version d’OpenZFS et de la structure initiale.
| Topologie | Disques minimum | Tolérance de panne | Usage pertinent |
|---|---|---|---|
| Disque unique | 1 | Aucune | Données temporaires ou environnement de test |
| Miroir | 2 | 1 disque dans un miroir à deux disques | Serveur domestique, virtualisation légère, besoin de simplicité |
| RAIDZ1 | 3 | 1 disque | Capacité optimisée avec risque de panne limité |
| RAIDZ2 | 4 | 2 disques | Volumes importants et marge de sécurité accrue |
| RAIDZ3 | 5 | 3 disques | Très grands ensembles où la reconstruction mérite une protection supplémentaire |
Comment faire : les étapes pour créer un pool ZFS de test
L’exemple suivant crée un miroir nommé tank avec deux disques repérés par leurs identifiants persistants. Les noms DISQUE_A et DISQUE_B sont des exemples à remplacer après vérification. N’exécutez jamais cette commande sur des supports contenant des données à conserver.
- Listez les disques et leurs identifiants :
ls -l /dev/disk/by-id/. - Contrôlez que les deux supports ne sont ni le disque système ni une sauvegarde existante.
- Créez le miroir :
sudo zpool create -o ashift=12 tank mirror /dev/disk/by-id/DISQUE_A /dev/disk/by-id/DISQUE_B. - Vérifiez immédiatement la topologie :
sudo zpool status -v tank. - Contrôlez la capacité :
sudo zpool list tank.
La propriété ashift=12 est fréquemment choisie pour aligner le pool sur des secteurs physiques de 4 Kio, mais sa pertinence doit être validée selon les supports utilisés. Le bon test n’est pas seulement l’absence d’erreur à la création : c’est la vérification explicite de chaque disque affiché par zpool status.
Organiser les données avec les systèmes de fichiers ZFS
Un dataset ZFS est un système de fichiers logique auquel ZFS peut appliquer des propriétés indépendantes. Créer plusieurs datasets évite de traiter tout le pool comme un répertoire unique. Cette séparation aide à isoler les données utilisateurs, les sauvegardes locales, les machines virtuelles ou les archives avec leurs propres quotas, règles de compression et politiques d’instantanés.
Créer une arborescence de datasets
Les commandes suivantes créent deux datasets dans le pool tank. Le point de montage est géré automatiquement selon la propriété mountpoint, généralement sous /tank si aucune autre valeur n’est définie. Vérifiez le chemin réel avec zfs list -o name,mountpoint.
sudo zfs create tank/documents
sudo zfs create tank/sauvegardes
sudo zfs list -o name,used,avail,refer,mountpoint
La compression ZFS peut être activée par dataset avec compression=on. La propriété s’applique aux nouveaux blocs écrits après son activation ; elle ne réécrit pas automatiquement les blocs anciens. Le gain réel dépend donc du type de fichiers : des documents texte ou des images disque peu compressées n’ont pas le même comportement que des fichiers déjà compressés.
sudo zfs set compression=on tank/documents
sudo zfs get compression,compressratio tank/documents
Quotas, réservations et surveillance de l’espace
Un quota limite l’espace qu’un dataset peut consommer, ce qui protège les autres datasets contre une croissance non maîtrisée. Une réservation garantit au contraire une part d’espace à un dataset. Ces propriétés doivent être appliquées avec prudence : une réserve trop élevée peut réduire la marge disponible pour les instantanés et compliquer l’exploitation quotidienne.
sudo zfs set quota=500G tank/documentslimite le dataset à 500 Gio.sudo zfs set reservation=100G tank/sauvegardesréserve 100 Gio au dataset.sudo zfs list -o name,used,avail,refer,compressratioaffiche l’occupation utile.sudo zfs get all tank/documentspermet d’inspecter les propriétés effectives.
Un pool ZFS ne doit pas être rempli sans surveillance. Les instantanés conservent les blocs modifiés ou supprimés tant qu’ils existent, ce qui peut réduire l’espace libre plus vite que prévu. Une alerte sur la capacité du pool est plus utile qu’un contrôle occasionnel fait après l’apparition d’une erreur d’écriture.
Comment utiliser les instantanés ZFS pour restaurer une version de fichier ?
Un instantané ZFS est une vue en lecture seule d’un dataset à un instant précis. La création est rapide car ZFS ne copie pas immédiatement tous les fichiers : les blocs anciens sont conservés lorsque les données actives changent. Un instantané permet donc de retrouver une version antérieure, à condition que le pool conserve encore assez d’espace.
La bonne pratique consiste à nommer les instantanés selon une convention lisible, par exemple une date et une action. Un instantané pris avant une mise à jour applicative répond à un besoin concret : revenir sur une erreur identifiable. Une accumulation sans rétention définie transforme rapidement cette fonction en dette de capacité.
Créer, consulter et supprimer un instantané ZFS
sudo zfs snapshot tank/documents@avant-mise-a-jour
sudo zfs list -t snapshot
sudo zfs destroy tank/documents@avant-mise-a-jour
La dernière commande détruit l’instantané indiqué et libère les blocs qui ne sont plus référencés par le dataset actif ou un autre instantané. Vérifiez toujours le nom complet avant d’utiliser zfs destroy. Une suppression d’instantané est définitive, sauf si une autre copie ou une réplication existe.
Un instantané est une protection contre certaines modifications locales ; une réplication est une copie transportée vers un autre stockage ; une sauvegarde doit aussi couvrir les scénarios de perte du pool ou du site.
Restaurer un fichier ou revenir à un état antérieur
Les instantanés apparaissent généralement dans le répertoire caché .zfs/snapshot du point de montage du dataset, si la propriété snapdir le permet. Copier un fichier depuis cet emplacement vers le système actif est souvent moins risqué qu’un retour global en arrière. Cette méthode limite la restauration à l’élément réellement concerné.
cp /tank/documents/.zfs/snapshot/avant-mise-a-jour/rapport.odt \
   /tank/documents/rapport.odt
La commande zfs rollback ramène un dataset à un instantané antérieur et peut supprimer des instantanés plus récents. Elle doit être réservée à une situation comprise et précédée d’une vérification de l’impact avec les options prévues par votre version d’OpenZFS. Une copie manuelle du fichier recherché reste souvent le choix le plus prudent.
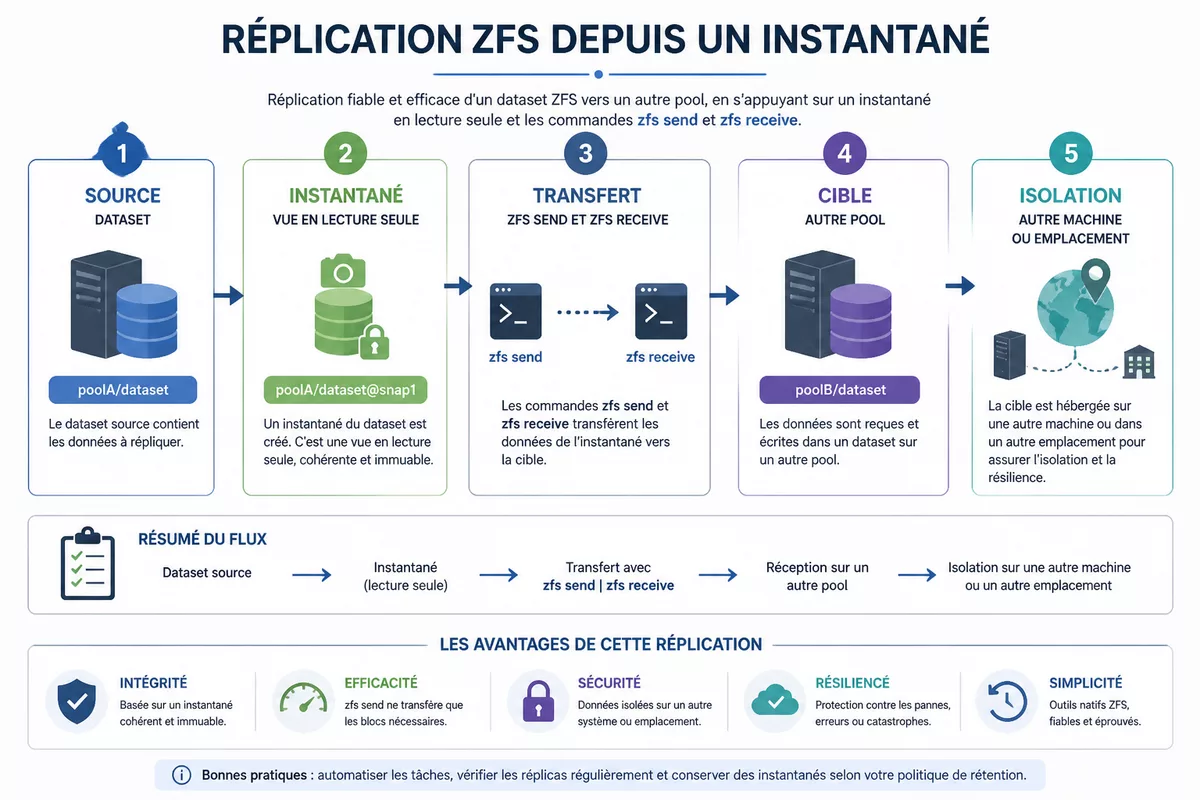
Répliquer les données : quand un instantané devient-il une sauvegarde ZFS ?
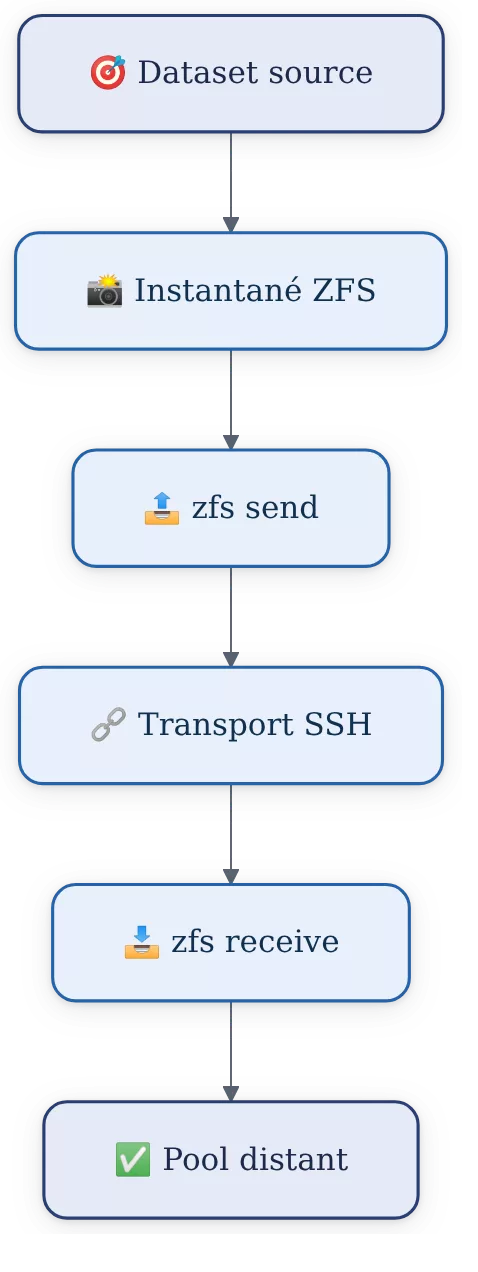
Un instantané devient une brique de sauvegarde ZFS lorsqu’il est envoyé vers un autre pool, idéalement sur une autre machine ou dans un autre emplacement. La paire zfs send et zfs receive transfère un flux représentant un instantané. La réplication protège alors contre une panne complète du pool source, mais seulement si la cible est administrée, surveillée et suffisamment isolée.
Une réplication locale sur le même serveur améliore rarement la protection face à une panne matérielle majeure, un sinistre ou un compte administrateur compromis. Pour un niveau de sécurité supérieur, la cible doit être séparée : autre serveur, autre alimentation, autre site ou stockage déconnecté selon le risque traité.
Exemple de transfert initial et incrémental
Un transfert initial peut envoyer un instantané vers un dataset de destination. L’exemple utilise un canal SSH et suppose que la machine distante possède un pool nommé backup. Les droits SSH, les permissions ZFS et la connectivité doivent être préparés avant de planifier une automatisation.
sudo zfs send tank/documents@2026-07-12 | \
ssh sauvegarde@serveur-distant sudo zfs receive -u backup/documents
Après un premier envoi, un flux incrémental peut transmettre les changements entre deux instantanés. La commande exacte dépend des noms retenus et de la présence effective des deux instantanés sur la source. Testez d’abord la restauration sur une cible non critique avant de considérer la chaîne de réplication comme exploitable.
sudo zfs send -i tank/documents@2026-07-12 tank/documents@2026-07-19 | \
ssh sauvegarde@serveur-distant sudo zfs receive -u backup/documents
Automatiser sans abandonner le contrôle
L’automatisation doit couvrir quatre éléments : création des instantanés, durée de conservation, transfert, contrôle du résultat. Un script qui crée des instantanés sans supprimer les plus anciens finit par saturer le pool. Un script qui transmet les flux sans vérifier le dataset cible peut produire une fausse impression de sécurité.
- Conservez des journaux de chaque envoi et de chaque erreur de réception.
- Contrôlez régulièrement les instantanés reçus avec
zfs list -t snapshotsur la cible. - Testez une restauration de fichier et une restauration dans un dataset isolé.
- Protégez les accès SSH utilisés pour la réplication avec des clés et des droits limités.
Maintenir l’intégrité du pool et remplacer un disque ZFS
La maintenance d’un pool ZFS repose sur une surveillance régulière de son état et sur des vérifications programmées. La commande zpool status -v indique l’état des vdev, les erreurs de lecture, d’écriture et de somme de contrôle, ainsi que l’avancement d’une scrutation. Un état DEGRADED mérite une analyse avant toute action précipitée.
Une scrutation, lancée par zpool scrub, relit les données pour valider les sommes de contrôle et réparer les blocs lorsque le pool dispose d’une redondance exploitable. La fréquence dépend du volume, de la charge et du niveau de criticité. La documentation et les manuels de votre version d’OpenZFS restent la référence pour interpréter les états affichés.
Commandes de contrôle à connaître
sudo zpool status -v
sudo zpool list
sudo zpool scrub tank
sudo zpool status tank
Une erreur de somme de contrôle ne désigne pas automatiquement un disque coupable. Le problème peut provenir du disque, du câble, du contrôleur, de la mémoire ou d’un autre élément de la chaîne. La décision prudente consiste à conserver la sortie de zpool status -v, vérifier les journaux système et recouper avec les diagnostics matériels avant de remplacer un composant.
Remplacer un disque défaillant avec prudence
Lorsqu’un disque doit être remplacé, identifiez d’abord le vdev concerné dans zpool status, puis relevez le chemin exact du disque en erreur. Après remplacement physique, la commande zpool replace associe le nouveau disque au vdev. La reconstruction, souvent appelée resilvering, doit être suivie jusqu’à son achèvement complet.
sudo zpool replace tank /dev/disk/by-id/ANCIEN_DISQUE /dev/disk/by-id/NOUVEAU_DISQUE
sudo zpool status tank
Le remplacement n’est pas un geste à standardiser aveuglément. Les identifiants changent selon les contrôleurs et les boîtiers, et une commande visant le mauvais support peut dégrader le pool. Conservez une documentation de vos numéros de série et de la correspondance entre baies physiques et chemins système.
Mémoire, ECC et composants avancés
La mémoire disponible influence le cache ARC de ZFS et donc le comportement du système sous charge. Les besoins réels varient avec le nombre de fichiers, la capacité, les charges de virtualisation et les propriétés activées. Proxmox VE indique dans sa documentation ZFS un minimum de 8 Go de mémoire pour ses configurations et recommande la mémoire ECC pour améliorer la détection d’erreurs matérielles ; ce repère ne constitue pas une règle universelle pour chaque serveur Linux.
Les composants tels que L2ARC, SLOG ou les vdev spéciaux répondent à des profils de charge précis. Les ajouter sans mesure peut augmenter la complexité, créer un nouveau point de panne ou ne produire aucun gain observable. Mesurez la latence, les entrées-sorties et le taux de cache avant d’investir dans ces options.
Comparer ZFS, Btrfs et mdadm : quel choix selon le besoin ?
ZFS sous Linux convient lorsque l’objectif est de gérer des pools, des datasets, des instantanés et une réplication cohérente avec des outils intégrés. Btrfs propose également des instantanés et des contrôles d’intégrité dans un autre modèle de système de fichiers. mdadm, souvent associé à LVM et ext4 ou XFS, sépare davantage la gestion RAID du système de fichiers.
Le choix doit partir de la charge et de l’exploitation prévue, pas d’un classement abstrait. ZFS apporte une chaîne fonctionnelle complète, mais demande une conception attentive du pool et une familiarité avec ses commandes. Btrfs peut être pertinent lorsqu’il est déjà intégré au système d’exploitation visé. mdadm reste une approche connue pour des architectures Linux traditionnelles où les couches sont administrées séparément.
| Solution | À privilégier pour | Atout principal | Limite à anticiper |
|---|---|---|---|
| ZFS | NAS, serveurs, réplication par instantanés | Pool, intégrité et datasets dans le même ensemble | Topologie initiale à planifier soigneusement |
| Btrfs | Systèmes Linux avec instantanés intégrés | Fonctions de système de fichiers intégrées | Évaluer la maturité selon le profil de stockage |
| mdadm + ext4 ou XFS | Architecture Linux classique et couches séparées | Écosystème largement connu des administrateurs | Instantanés et gestion de volume à ajouter séparément |
Les erreurs fréquentes avec ZFS sous Linux
Les difficultés avec ZFS viennent rarement d’une seule commande. Elles naissent plutôt d’une topologie improvisée, d’une surveillance insuffisante ou d’une confusion entre redondance et sauvegarde. Les erreurs suivantes sont évitables dès la phase de préparation.
- Créer un pool avec des chemins
/dev/sdX. Ces noms peuvent changer après un redémarrage ; utilisez les identifiants stables de/dev/disk/by-id. - Penser qu’un RAIDZ est extensible comme un simple dossier. Vérifiez les capacités de votre version et concevez le nombre de vdev avant l’achat des disques.
- Activer la déduplication sans mesure préalable. La déduplication peut demander beaucoup de mémoire et n’est pas une optimisation par défaut.
- Empiler les instantanés sans politique de rétention. Les blocs conservés peuvent faire baisser l’espace libre jusqu’à bloquer les écritures.
- Traiter la réplication locale comme une sauvegarde complète. Une copie sur le même matériel reste exposée à de nombreux incidents communs.
Sources utiles à consulter
La documentation technique évolue avec les versions d’OpenZFS et des distributions. Les références suivantes permettent de vérifier les commandes, les propriétés et la compatibilité avant un déploiement sur des données de production.
- Documentation OpenZFS : guides, manuels et propriétés ZFS à vérifier selon la version installée.
- Projet OpenZFS sur GitHub : versions, notes de publication et compatibilité du projet.
- Documentation Proxmox VE sur ZFS sous Linux : repères matériels et explications orientées exploitation.
- Manuels Debian : vérification des options disponibles dans les paquets de votre distribution.
À retenir
- 🧩 Concevez la topologie du pool avant de créer le moindre vdev.
- 📸 Utilisez les instantanés pour restaurer, pas comme unique sauvegarde.
- 🔗 Répliquez les données vers un stockage réellement distinct du pool source.
- 🔍 Lancez des scrutations et interprétez les erreurs avant de remplacer un disque.
- ⚠️ Vérifiez chaque identifiant disque avant toute commande destructive ZFS.
Questions fréquentes sur ZFS sous Linux
ZFS est-il adapté à un serveur personnel ?
ZFS peut convenir à un serveur personnel si les besoins incluent les instantanés, la vérification d’intégrité et une organisation par datasets. La configuration doit rester proportionnée au matériel et à la capacité d’administration disponible. Un miroir à deux disques est souvent plus simple à exploiter qu’une topologie complexe mal documentée.
Combien de disques faut-il pour commencer avec ZFS ?
Un pool ZFS peut être créé sur un seul disque pour un test, sans redondance. Un miroir nécessite au moins deux disques. Pour les configurations RAIDZ, la documentation OpenZFS recommande au minimum trois disques pour RAIDZ1, quatre pour RAIDZ2 et cinq pour RAIDZ3.
Peut-on agrandir un pool ZFS plus tard ?
Un pool peut généralement gagner de la capacité par ajout d’un nouveau vdev, mais ce choix modifie la structure globale du pool. L’extension d’un vdev existant dépend de sa topologie et de la version d’OpenZFS. Il faut donc vérifier la documentation de la version installée avant de planifier une évolution.
Les instantanés ZFS occupent-ils beaucoup d’espace ?
Un instantané ne duplique pas immédiatement tous les fichiers. Son espace augmente quand les blocs présents lors de sa création sont modifiés ou supprimés dans le dataset actif. Des instantanés anciens sur des données très changeantes peuvent donc consommer une part importante du pool.
Que faire en cas d’erreurs de somme de contrôle ZFS ?
Commencez par enregistrer la sortie de zpool status -v, puis contrôlez les journaux système, les câbles, le contrôleur et les diagnostics du disque concerné. Une scrutation peut identifier ou réparer certains blocs sur un pool redondant. Ne remplacez pas un disque sur la seule base d’une alerte isolée sans recoupement matériel.