Surveiller un serveur auto-hébergé avec des outils libres : méthode complète et alertes fiables
Surveiller un serveur auto-hébergé avec des outils libres : méthode complète et alertes fiables
Surveiller un serveur auto-hébergé consiste à mesurer en continu ses ressources, la disponibilité de ses services et ses erreurs afin de détecter une panne avant qu’elle ne bloque les utilisateurs. Une méthode simple associe des métriques système, des contrôles de disponibilité et des alertes configurées avec des seuils cohérents.
La supervision serveur ne remplace ni une sauvegarde ni un plan de restauration. Ce tutoriel explique comment choisir des outils libres, définir les indicateurs utiles, sécuriser les interfaces d’administration, paramétrer des alertes exploitables et vérifier que la surveillance fonctionne réellement.
En bref
🎯 Commencez par surveiller CPU, mémoire vive, espace disque, réseau et services critiques plutôt que de collecter toutes les métriques possibles.
⚙️ Pour un premier déploiement, Netdata offre une vue immédiate du serveur ; Uptime Kuma complète le dispositif avec des contrôles de disponibilité HTTP, TCP ou DNS.
📊 Pour plusieurs machines ou des conteneurs, Prometheus et Grafana apportent une collecte historique et des tableaux de bord plus modulables, au prix d’une configuration plus longue.
🔒 Une interface de supervision ne doit pas être exposée directement sur Internet sans contrôle d’accès, chiffrement et mises à jour régulières.
Pourquoi surveiller un serveur auto-hébergé ?
La surveillance d’un serveur auto-hébergé permet de repérer une saturation de mémoire, un disque presque plein, une latence réseau anormale ou un service inaccessible avant que le problème ne devienne visible pour les utilisateurs. Une supervision utile relie chaque mesure à une action : diagnostiquer, alerter ou intervenir.
Un serveur peut continuer à répondre au ping alors que son site web, sa base de données ou son reverse proxy sont déjà dégradés. La disponibilité de la machine ne prouve donc pas la disponibilité du service rendu. Le monitoring doit vérifier le système et les services qui dépendent réellement du serveur.
Ce que la supervision doit mesurer
Les métriques serveur sont des valeurs techniques relevées à intervalles réguliers pour décrire l’état d’une machine. Les indicateurs pertinents dépendent des applications hébergées, mais un socle minimal reste valable pour un VPS, un mini-PC domestique ou un serveur dédié Linux.
- CPU et charge système : une charge durablement élevée peut signaler un processus bloqué, une tâche planifiée trop lourde ou une demande inhabituelle.
- Mémoire vive et swap : une hausse continue de la mémoire consommée ou l’usage régulier du swap mérite une analyse avant un arrêt de service.
- Espace disque et inodes : les journaux, sauvegardes locales et volumes de conteneurs remplissent souvent le stockage sans symptôme immédiat.
- Réseau et latence : les pertes, erreurs d’interface et temps de réponse aident à distinguer un problème applicatif d’un problème réseau.
- Services critiques : HTTP, HTTPS, SSH, DNS, base de données, conteneurs et processus applicatifs doivent être contrôlés selon votre usage réel.
- Journaux système : les logs apportent le contexte nécessaire lorsqu’une métrique ou une vérification de disponibilité échoue.
Une alerte utile désigne un symptôme précis, un seuil compréhensible et une action possible. Une alerte vague ne fait qu’ajouter du bruit.
Comment surveiller un serveur auto-hébergé : les étapes essentielles
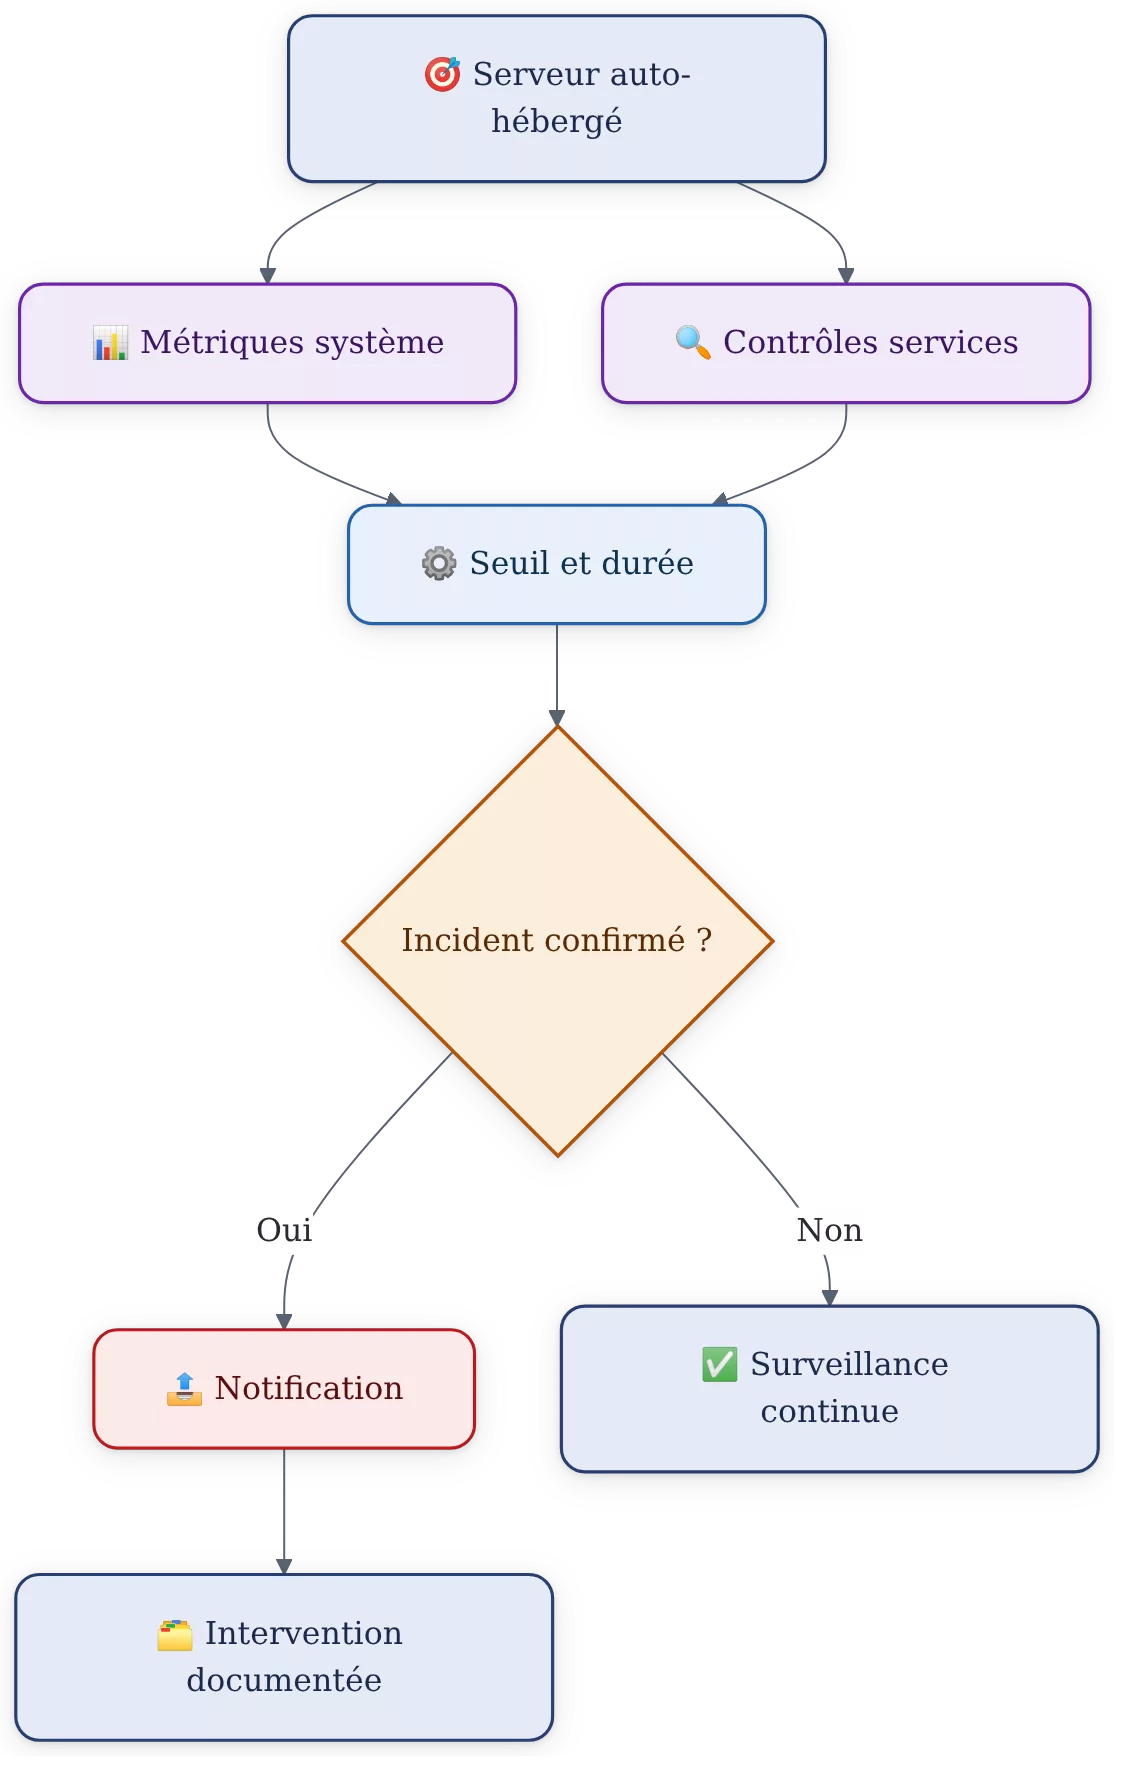
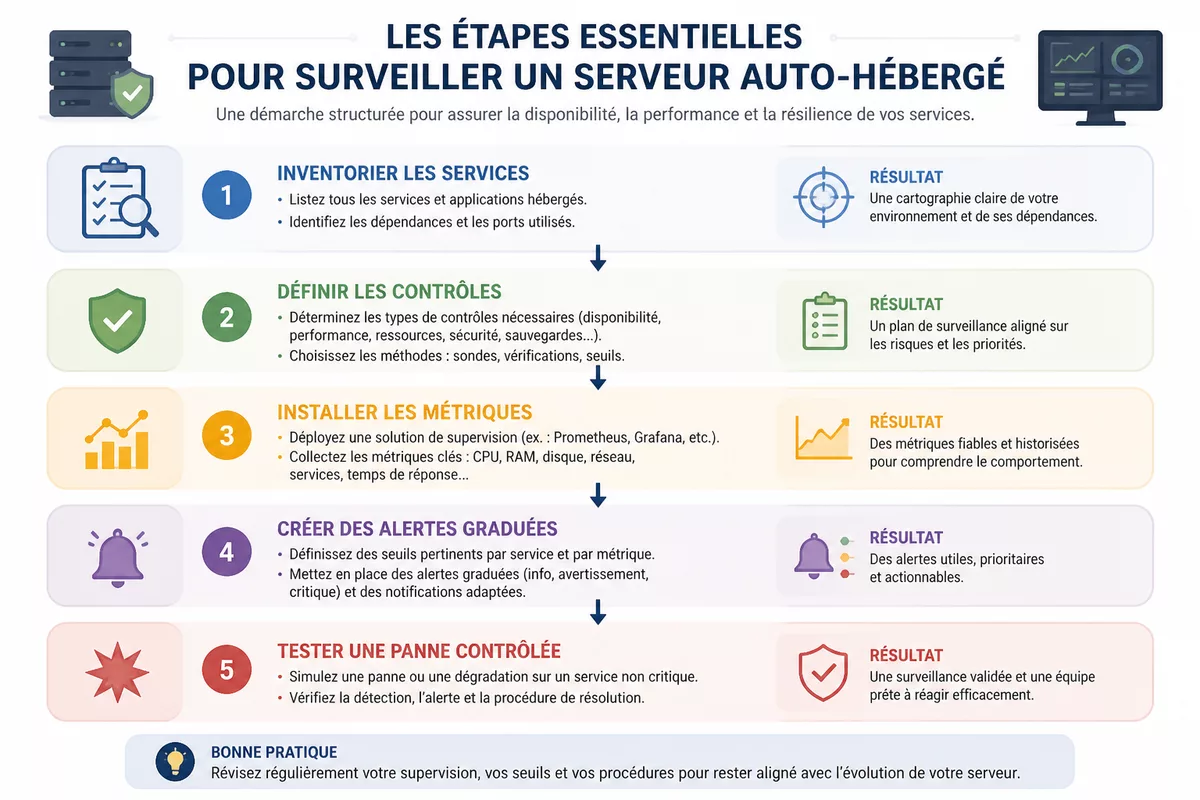
Pour surveiller un serveur auto-hébergé sans construire une usine à gaz, procédez dans cet ordre : inventorier les services, définir les contrôles, installer une première couche de métriques, créer des alertes graduées puis tester une panne contrôlée. Cette progression limite les tableaux de bord inutiles et les notifications trompeuses.
Étape 1 : inventorier les services à protéger
Listez les composants dont l’indisponibilité a un impact concret : site web, API, serveur de fichiers, base de données, VPN, relais mail ou application métier. Pour chaque composant, notez l’adresse ou le port à tester, le responsable, la dépendance principale et la réaction attendue en cas d’alerte.
Un serveur qui héberge un site et une base de données nécessite au minimum un contrôle HTTPS côté utilisateur, un contrôle du processus web et une mesure de l’espace disponible pour les données. Une liste courte de services réellement critiques vaut mieux qu’une surveillance exhaustive sans priorité.
Étape 2 : choisir les indicateurs et les seuils initiaux
Créez d’abord des seuils d’observation, pas des seuils de panique. Une mémoire utilisée à 80 % n’est pas toujours un incident sous Linux, car le système emploie la mémoire disponible comme cache. Le signal utile dépend davantage du swap, des erreurs applicatives, des temps de réponse et de la durée de la saturation.
- Définissez une alerte de capacité pour un disque qui se remplit durablement.
- Ajoutez une alerte de disponibilité pour chaque endpoint ou port critique.
- Ajoutez une alerte de performance lorsque le temps de réponse dépasse votre niveau de service habituel pendant plusieurs contrôles.
- Ajoutez une alerte de santé applicative à partir des logs ou du code HTTP retourné.
Étape 3 : séparer la mesure locale du contrôle externe
Un agent installé sur le serveur mesure très bien le CPU, la RAM et les processus, mais il ne peut plus envoyer d’alerte si la machine entière est arrêtée ou isolée du réseau. Installez donc un contrôle de disponibilité depuis une seconde machine, un autre site ou un petit VPS distinct lorsque l’enjeu le justifie.
Uptime Kuma est un outil libre orienté disponibilité qui peut vérifier une URL HTTP(S), un port TCP, un serveur DNS ou un ping selon le type de moniteur choisi. Un contrôle extérieur permet de détecter le cas le plus gênant : le serveur pense fonctionner, mais il n’est plus joignable depuis Internet.
Étape 4 : relier chaque alerte à une décision
Associez une action explicite à chaque notification : attendre et observer, libérer de l’espace, redémarrer un service, basculer sur une procédure de secours ou ouvrir un incident. Une alerte sans consigne de traitement pousse souvent à des redémarrages précipités qui effacent les indices présents dans les journaux.
Quels outils libres choisir pour la supervision serveur ?
Le bon outil libre de supervision dépend moins du nombre de fonctions affichées que du niveau de détail nécessaire, du nombre de machines et du temps disponible pour l’administration. Netdata convient à une lecture immédiate d’un hôte ; Prometheus et Grafana structurent une supervision historique ; Zabbix couvre plus largement plusieurs systèmes et équipements.
| Outil | Usage principal | Point fort | Limite à anticiper | Adapté à |
|---|---|---|---|---|
| Netdata | Métriques système et applicatives en temps réel | Visualisation immédiate et collecte automatique | Le stockage historique et les alertes demandent un paramétrage adapté | Un serveur Linux ou un premier déploiement |
| Prometheus + Grafana | Collecte de métriques, requêtes et tableaux de bord | Architecture modulaire et historique exploitable | Configuration des exports, règles et stockage à prévoir | Plusieurs services, conteneurs ou hôtes |
| Zabbix | Supervision système, réseau et services | Modèles, alertes et surveillance centralisée | Déploiement plus structurant pour un simple serveur | Parc de machines hétérogène |
| Uptime Kuma | Disponibilité de services et endpoints | Contrôles simples et notifications | Ne remplace pas la collecte complète de métriques système | Sites, API, ports et services critiques |
Netdata pour surveiller les ressources d’un serveur Linux
Netdata est une plateforme de supervision qui collecte et affiche des métriques système et applicatives sous forme de graphiques. Sa documentation indique une collecte automatique de plus de 2 000 métriques avec une granularité pouvant aller à la seconde, selon les collecteurs activés et l’environnement.
Netdata est pertinent pour comprendre rapidement pourquoi un serveur ralentit : pression mémoire, accès disque, charge d’un processus, trafic réseau ou activité d’un conteneur. La contrepartie est claire : cette richesse visuelle doit rester protégée, car des métriques détaillées révèlent souvent la structure et l’activité de l’infrastructure.
Prometheus et Grafana pour l’historique et les tableaux de bord
Prometheus collecte des métriques principalement en mode pull via HTTP et les conserve dans une base de données temporelle. Grafana interroge ensuite Prometheus, entre autres sources, pour construire des tableaux de bord, comparer des périodes et isoler une anomalie.
Cette association convient lorsque les données doivent être comparées sur plusieurs jours ou plusieurs hôtes. Prometheus demande toutefois des exporteurs pour exposer les métriques des systèmes et applications, ainsi qu’une réflexion sur la rétention des données et les alertes.
Zabbix pour plusieurs serveurs et équipements
Zabbix est une solution de supervision centralisée qui couvre les systèmes, les services et des équipements réseau. Zabbix peut surveiller localement ou à distance et envoyer des notifications selon des déclencheurs définis dans son interface.
Zabbix devient cohérent lorsque plusieurs machines demandent des modèles de surveillance homogènes. Pour un seul VPS, son périmètre peut être disproportionné si le besoin se limite à quelques métriques et à une vérification HTTP.
Uptime Kuma pour une alerte serveur indisponible
Uptime Kuma est un outil auto-hébergé de contrôle de disponibilité. Son approche est volontairement plus étroite que celle de Prometheus ou Zabbix : vérifier régulièrement qu’un service répond avec le protocole et le résultat attendus, puis notifier un canal configuré.
Uptime Kuma ne mesure pas la consommation mémoire d’un processus et ne remplace pas un tableau de bord serveur. Uptime Kuma complète bien Netdata ou Prometheus lorsqu’un contrôle externe de site internet, d’API ou de port réseau est nécessaire.
Étape 5 : installer une première couche de surveillance sans exposer l’interface
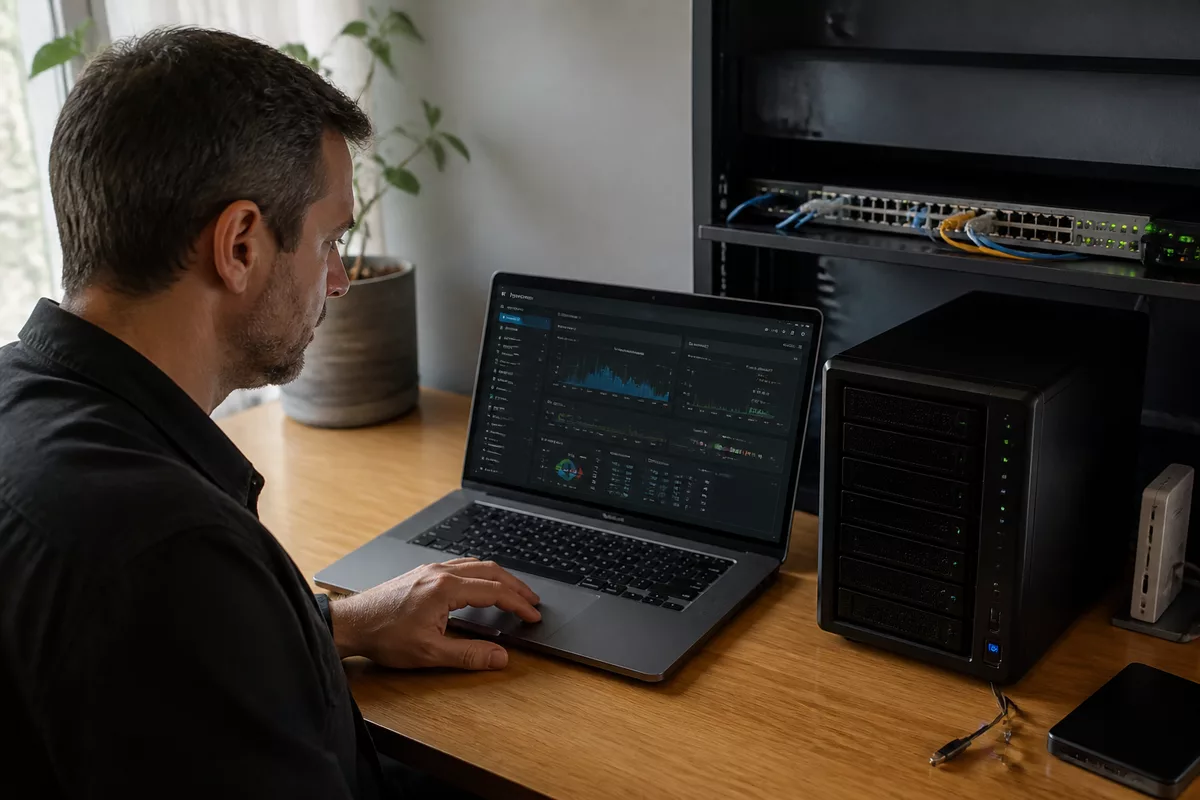
Installez d’abord un seul outil de métriques sur un environnement non critique ou sur un serveur de test, puis ajoutez les contrôles de disponibilité. Consultez la documentation officielle de l’outil choisi pour la méthode d’installation correspondant à votre distribution Linux, votre gestionnaire de paquets ou votre déploiement par conteneur.
Étape 6 : préparer l’accès et les dépendances
Vérifiez la version de votre système, l’espace disque disponible, les ports déjà utilisés et le mode de déploiement retenu avant l’installation. Un déploiement par conteneur simplifie souvent l’isolation, mais il implique de surveiller aussi les volumes persistants, le moteur de conteneurs et les réseaux définis par la plateforme.
Documentez l’adresse d’écoute de chaque interface et évitez les conflits de ports. Pour comprendre les risques d’un service local rendu accessible par le réseau, consultez ce guide pour configurer un port de service local sans confondre écoute locale et exposition publique.
Étape 7 : sécuriser l’interface de supervision
Limitez l’accès aux tableaux de bord par un pare-feu, un VPN ou un reverse proxy avec authentification forte. Activez le chiffrement HTTPS lorsque l’interface est accessible via le réseau, créez des comptes distincts et évitez d’utiliser le compte administrateur pour la consultation courante.
Une plateforme de supervision expose souvent des noms d’hôtes, des adresses internes, des versions de services et des graphiques d’activité : elle doit être traitée comme une interface d’administration sensible. La démarche détaillée pour réduire les risques d’un VPS Linux s’applique aussi aux composants de monitoring.
- Écoutez l’interface sur le réseau privé lorsque cette option existe.
- Restreignez les accès entrants aux seules adresses ou réseaux d’administration nécessaires.
- Utilisez des mots de passe uniques et une authentification multifacteur si l’outil la propose.
- Mettez à jour l’outil de supervision, son système hôte et ses dépendances.
- Sauvegardez les configurations, règles d’alerte et volumes de données avant une mise à niveau.
Étape 8 : construire un tableau de bord et des alertes fiables
Un tableau de bord serveur doit répondre rapidement à trois questions : le service est-il disponible, quelle ressource limite la machine et depuis quand le comportement a-t-il changé ? Affichez d’abord ces indicateurs sur une même vue avant d’ajouter des graphiques secondaires.
Créer une vue d’ensemble exploitable
Placez la disponibilité HTTP ou TCP, l’espace disque, la charge CPU, la mémoire disponible, l’activité réseau et les erreurs applicatives sur une vue courte. Un graphique isolé est rarement suffisant : la corrélation entre une hausse de latence, un pic CPU et des erreurs de service accélère le diagnostic.
La supervision réseau gagne aussi à inclure les dépendances locales, notamment lorsqu’un serveur communique avec une passerelle ou une autre machine du LAN. Le fonctionnement du protocole ARP sur un réseau local aide à interpréter certains problèmes de connectivité entre équipements voisins.
Définir des alertes qui ne réveillent pas pour rien
Une alerte fiable combine une condition, une durée et un niveau de gravité. Par exemple, un espace disque qui augmente progressivement peut produire un avertissement, tandis qu’un service HTTPS qui échoue plusieurs fois de suite peut déclencher une alerte urgente.
Évitez les seuils copiés sans contexte. Le bon seuil est celui qui détecte une dégradation assez tôt tout en laissant le temps d’agir avant l’indisponibilité. Observez le comportement normal du serveur pendant plusieurs jours avant de figer les valeurs d’alerte.
Une alerte de disponibilité doit être confirmée par plusieurs contrôles rapprochés, sauf incident critique explicitement identifié, afin de réduire les faux positifs liés à une fluctuation réseau brève.
Choisir un canal de notification adapté
Configurez au moins un canal qui reste consulté en dehors du serveur surveillé : messagerie, courrier électronique, application de notification ou passerelle dédiée. Vérifiez aussi que la notification est reçue lorsqu’un service de messagerie local est lui-même indisponible.
Une notification de rétablissement est aussi importante que l’alerte initiale. Elle permet de distinguer une coupure transitoire d’un incident toujours en cours et d’éviter une investigation inutile après le retour à la normale.
Erreurs fréquentes quand on monitorer un serveur
Les erreurs de configuration viennent rarement de l’outil lui-même. Elles apparaissent surtout lorsque les contrôles ne correspondent pas au service réel, lorsque les alertes sont trop sensibles ou lorsque le serveur de supervision dépend du même point de panne que la machine surveillée.
| Erreur | Pourquoi c’est un problème | Comment l’éviter |
|---|---|---|
| Surveiller uniquement le ping | La machine répond alors que le site, l’API ou la base de données est indisponible | Ajoutez un contrôle applicatif HTTP, TCP ou de requête métier simple |
| Déclencher une alerte sur un pic bref | Les notifications deviennent fréquentes et sont ignorées | Ajoutez une durée minimale ou plusieurs échecs consécutifs |
| Héberger tous les contrôles sur le serveur surveillé | Une panne totale coupe aussi les mécanismes d’alerte | Placez au moins un contrôle de disponibilité sur une machine distincte |
| Exposer un tableau de bord sans restriction | Les informations d’infrastructure deviennent accessibles à des tiers | Utilisez VPN, filtrage réseau, HTTPS et authentification robuste |
| Confondre monitoring et sauvegarde | Une alerte constate un problème, elle ne restaure aucune donnée | Testez séparément vos sauvegardes et votre procédure de restauration |
Étape 9 : tester les alertes avant de leur faire confiance
Une alerte non testée reste une hypothèse. Testez les contrôles après leur mise en place, puis après chaque changement important de réseau, de reverse proxy, de certificat, de firewall ou de service de notification.
Simuler une panne sans endommager le serveur
Choisissez un service non critique ou une fenêtre de maintenance, puis arrêtez temporairement le processus concerné selon la procédure habituelle de votre système. Vérifiez la chronologie complète : détection, délai, réception de l’alerte, contenu du message, rétablissement et notification de retour à la normale.
Notez l’heure de chaque étape et comparez-la aux attentes définies dans vos règles. Un retard peut venir de l’intervalle de collecte, du nombre de tentatives de contrôle ou du canal de notification, pas nécessairement de l’outil de monitoring.
Vérifier ce que la supervision ne voit pas
Une supervision ne détecte pas automatiquement une restauration de sauvegarde inutilisable, une erreur métier dans une application qui répond encore en HTTP ou une fuite de données. La surveillance doit être complétée par des tests de restauration, des mises à jour de sécurité et des contrôles applicatifs adaptés aux risques réels.
Quelle solution choisir selon votre serveur auto-hébergé ?
Le choix d’une solution de supervision auto-hébergée doit suivre la taille de l’environnement et la question à laquelle vous voulez répondre. Netdata répond vite à « quelle ressource ralentit ce serveur ? », Uptime Kuma à « ce service est-il accessible ? », tandis que Prometheus, Grafana ou Zabbix répondent mieux à « que s’est-il passé sur plusieurs machines au fil du temps ? ».
Un seul VPS ou un serveur domestique
Associez Netdata pour la visibilité locale et Uptime Kuma sur une machine distincte si vous avez besoin d’une alerte serveur indisponible depuis l’extérieur. Cette combinaison limite la charge opérationnelle tout en couvrant les ressources serveur et la disponibilité des services publics.
Plusieurs serveurs Linux et quelques services réseau
Préférez Zabbix si vous avez besoin d’un inventaire centralisé, de modèles réutilisables et de contrôles systèmes ou réseau variés. Prometheus avec Grafana reste pertinent lorsque les applications exposent déjà des métriques et que les équipes veulent analyser les séries temporelles avec précision.
Conteneurs et applications modulaires
Prometheus et Grafana sont généralement plus adaptés à la surveillance des conteneurs lorsque les exporteurs et les métriques applicatives sont prévus dès le déploiement. Gardez un outil de disponibilité séparé pour vérifier le parcours réellement exposé aux utilisateurs, notamment l’URL HTTPS publique.
Mettre la supervision dans la durée
Conservez une documentation simple : services surveillés, seuils, canaux d’alerte, comptes d’accès, emplacement des sauvegardes de configuration et procédure de mise à jour. La documentation réduit le temps de réaction lorsqu’une personne différente doit traiter l’alerte.
Révisez régulièrement les alertes qui se déclenchent sans action utile et les services devenus inutiles. Une supervision mature produit moins de bruit, mais des signaux plus clairs lorsque l’intervention est réellement nécessaire.
À retenir
- 🎯 Surveillez les services rendus, pas seulement la disponibilité du serveur.
- 📊 Commencez avec CPU, mémoire, disque, réseau, logs et contrôles HTTP.
- 🔗 Séparez les métriques locales des vérifications externes de disponibilité.
- ⚠️ Ajoutez une durée ou plusieurs échecs pour réduire les faux positifs.
- 🔒 Protégez les tableaux de bord comme toute autre interface d’administration.
Questions fréquentes sur la supervision auto-hébergée
Quel outil libre choisir pour commencer à surveiller un serveur ?
Netdata convient à une première supervision des ressources d’un serveur Linux grâce à ses graphiques immédiats. Ajoutez Uptime Kuma si vous devez vérifier qu’un site, une API ou un port reste accessible depuis un autre point du réseau.
Quels indicateurs surveiller en priorité sur un VPS Linux ?
Surveillez d’abord l’espace disque, les inodes, la mémoire, le swap, la charge CPU, le trafic réseau et la disponibilité des services critiques. Ajoutez ensuite des contrôles applicatifs, comme une URL HTTPS qui retourne le code attendu.
Prometheus et Grafana sont-ils nécessaires pour un seul serveur ?
Prometheus et Grafana ne sont pas obligatoires pour un seul serveur. Cette combinaison devient utile lorsque vous voulez conserver un historique détaillé, croiser plusieurs métriques ou étendre progressivement la surveillance à des applications et plusieurs hôtes.
Comment éviter les fausses alertes de serveur indisponible ?
Configurez plusieurs tentatives avant notification pour les services non critiques et choisissez un intervalle cohérent avec votre besoin. Testez aussi le contrôle depuis un emplacement distinct afin de distinguer une panne du serveur d’un problème du moniteur lui-même.
Le monitoring serveur remplace-t-il les sauvegardes ?
Le monitoring détecte des anomalies et déclenche des alertes, mais il ne restaure pas les fichiers, bases de données ou configurations perdues. Une stratégie fiable combine supervision, sauvegardes séparées et tests réguliers de restauration.